前言
渗透智能体可能算是如今 AI for Secuirty 最火热的方向,甚至可以没有之一,从去年年底的第一次腾讯 AI 渗透大赛,当时还是做的 XBow 这样的 CTF 型的题目,到今年百花齐放,百度、字节等各家都在办自己的 AI 渗透大赛,题目也从过去玩具一样的 CTF 题目到如今极其复杂的多阶段渗透题目。随着基模能力的提升,渗透智能体的能力也越来越超乎大家的想象,放去年,如果某个厂商说自家的渗透智能体打护网能第一,可能大家会觉得是背后的安服仔累冒烟了,但放在今年,大家会相信这确实是渗透智能体自己的能力,毕竟关于 Artex 、 Cairn 的新闻层出不穷,一个好的开源渗透智能体搭配 deepseek 就能拥有超越过去资深红队的能力,独自完成大型项目的突破。
2023:Assistant for Pentest
回顾AI for Secuirty的发展历史,利用 LLM 辅助进行渗透测试的想法并不稀奇,早在 cursor、claude code 这类通用 Agent 还未出现的 2023 年,8 月发布在 arXiv 上的 PentestGPT 就小小的火了一把。PentestGPT 的作者认为 LLM 已经具备一定的渗透测试知识,能够理解工具输出、提出攻击思路和生成命令,但很难在漫长的渗透过程中保持完整的上下文,比如 LLM 可能在扫描多个服务后忘记之前发现的漏洞线索,或者过度关注眼前的任务,缺乏全局规划能力,于是 PentestGPT 将渗透测试拆分成三个由独立 LLM Session 驱动的模块:
- 推理模块:负责整体攻击规划。利用 Pentesting Task Tree(PTT)记录已发现的信息、任务进度与候选攻击路径,并决定下一步应该做什么。
- 生成模块:负责具体操作。将推理模块选定的任务转化为可执行的渗透测试命令,例如 Nmap 扫描命令。
- 解析模块:负责处理工具输出、HTTP 响应和源代码等信息,提取关键内容,避免大量冗余文本占用上下文。
三个模块彼此之间形成一个循环:Reasoning(根据 PTT 选择下一步渗透任务)->Generation(生成具体的工具命令和操作步骤)->人工执行测试命令(获得目标环境的真实反馈)->Parsing(提取执行结果中的关键信息,反馈给 Reasoning 更新 PTT)->进入下一轮
当然,敏锐的师傅已经发现了,怎么这个渗透智能体也不智能啊,为什么还得人工执行命令?这就要说到当时 2023 年的业界风潮了,当时的主流 Agent 思想是利用 workflow 把流程写死,让路径先于执行确定,节点负责局部工作,路径和传递关系由人预先设计,Dify 也就是在那时候火起来的。由于人们需要可控性,并不那么信任将一切都交给 LLM 自主完成,所以这种系统本质上还只是Human-in-the-Loop 的半自动系统。和如今人负责意图指定,AI 负责执行的路子相反,当时的主流的思想还是 AI 负责规划、生成命令与分析反馈,具体命令仍由人类执行,再将结果反馈给系统,所以 PentestGPT 其实还称不上是真正的渗透智能体,而只是一个能够规划攻击步骤、分析执行结果的智能渗透助手。
2024:Subtask for Pentest
随着 LLM 和 Agent 的发展,人们愈发意识到 PentestGPT 所代表的路线并不是真正的渗透智能体,我们想要的不是让 LLM 辅助渗透测试,而是需要让 LLM 自主完成从信息收集、漏洞分析到漏洞利用的完整流程,于是一年后的 arxiv 上出现了一篇名为 PentestAgent 的论文。从论文名字上也能看出差别,PentestGPT 只是 GPT,还只是一个 ChatBox,而 PentestAgent 代表了更大的野心,他们想要的不只是一个对话机器人,而是一个能独立完成完整渗透任务的智能体。
这时以 PentestAgent 为代表的 Agent 将渗透拆分成不同的子任务,用不同的子 Agent 来负责不同的环节:
- 信息收集:自主执行 Nmap 等工具,根据执行结果迭代扫描,识别目标服务及版本,并记录环境信息。
- 知识检索:根据发现的服务和版本,搜索漏洞数据库、GitHub、ExploitDB 等资源,收集相关 CVE、PoC 和利用教程。
- 攻击规划:借助 RAG,从检索结果中先筛选潜在攻击面,再选择具体的漏洞利用方案。
- 攻击执行:根据 PoC 和目标环境准备参数、执行利用,并通过 Self-reflection 分析执行错误、修改命令或代码后重试。
这时由于 RAG 技术的流行,以及模型厂商并没有把重点放在 cyber 模型上,原始的模型虽然训练了一部分网安数据,但在网安任务上的表现仍没有那么智能,于是利用 RAG 为模型补充所缺少的安全知识成为了常态,以 PentestGPT 为例,PentestGPT 将知识分为两个层次:
- Coarse-grained Knowledge:哪些软件版本可能存在什么漏洞。
- Procedure-level Knowledge:这些漏洞具体应该如何利用,包括 PoC 和执行条件。
此时的渗透智能体虽然终于能够摆脱人工干预了,但还是有一个很大的缺点,与其说它是渗透智能体,不如说它是一个 CVE 复现智能体,其主要工作方式其实只是识别目标软件、检索已知漏洞、找到现成 PoC,再尝试执行。因此,PentestAgent 虽然能够自动完成许多已知漏洞的利用任务,却不代表它具备很强的未知漏洞发现能力。作者自己也在论文中坦率的提到,复杂的多漏洞组合与攻击链规划不在其主要研究范围内。
2025:Pentest for CTF
到了 2025 年年底,腾讯举办了第一届 AI 渗透大赛,国内涌现出了许多优秀的渗透智能体,但值得注意的是,此时比赛的题目仍然只是 CTF 题目 Xbow,所以此时的经验其实并不一定能直接复用到真实环境中。当我们听第一届比赛的战队的答辩时,也能看出来他们大部分是继承了 PentestGPT 的思想,将完整的渗透任务拆分成不同的子任务交给不同的子 Agent 完成,给 LLM 提供专家经验,对渗透场景进行特定的建模,且越来越多的系统开始直接利用通用 Agent 架构:
- Plan-and-Execute:先将渗透目标拆解成多个子任务,再逐步执行。
- ReAct:在每个子任务内部不断进行推理、工具调用、观察反馈和调整。
- MCP + Sandbox:通过统一接口调用终端、浏览器等工具,在隔离环境中自主进行渗透测试
比如涙笑师傅将这种建模称作”意图工程”,他认为人类渗透测试专家并不是毫无章法地探索,而是针对不同环境有不同的测试策略。例如,测试办公网网站时,可能先判断认证机制,再根据认证结果选择后续测试方向,于是他希望把安全专家的渗透经验从代码和 Prompt 中抽离出来,变成可复用、可组合的执行流程,把安全专家经验显式建模,他将这样的结构称作 Agent Pattern Graph(APG),使用 YAML 定义有向图:
- 节点表示高层测试任务、预期输出。
- 边表示根据执行结果选择的下一步。
- Runtime 负责解释执行,由 Agent 完成节点中的具体任务。
另一个变化在于,过去大家尝试用 MCP 之类的方式给 LLM 提供 tool,但对着基模能力的提升,其实完全不必再让 LLM 逐个调用工具,而是让 LLM 编写 Python 代码,由代码批量编排工具调用、处理结果,最后只把关键信息返回给模型,这个设计同时减少了 LLM 调用次数和无关中间信息进入上下文的问题
2026:Pentest for Realworld
随着第二届腾讯 AI 渗透大赛的举办,渗透智能体的架构终于又迎来了新的颠覆性的改变。无论是 24 年还是 25 年,大家都是预定义 Recon、Planning、Execution 等角色,或者安排固定的攻击流程,但涙笑师傅认为不应预先规定 Agent 应当如何渗透,而是让多个 Agent 基于共享事实,自主探索通往目标的路径,渗透测试本质上只有三个要素:
- Origin(起点):已知的目标及初始环境。
- Goal(终点):明确的任务完成条件,例如获取 Flag。
- Path(路径):未知,需要 Agent 自主探索。
因此,Cairn 不预定义角色、不预定义工作流,也不强制遵循某套渗透测试方法论,而是围绕目标持续搜索,核心是一个共享黑板,所有 Agent 都围绕黑板工作,黑板维护三类信息:
- Fact:已确认的事实,例如发现某个服务或成功验证某个漏洞
- Intent:下一步准备探索的方向,例如尝试某种攻击路径
- Hint:人类提供的提示或额外判断
这些信息逐渐形成一张从 Origin 向 Goal 生长的 Fact–Intent Graph,多个平等的 Worker 通过共享黑板间接协作,不需要互相发送消息,也没有固定的“扫描专家”“漏洞专家”等角色,这种协作方式被作者称为 Stigmergy,类似蚁群通过共享环境留下的信息协调行动,系统只有三种任务类型:
- Bootstrap:首先尝试直接完成 Goal
- Reason:读取现有 Fact,判断目标是否完成,生成新的 Intent
- Explore:Worker 领取 Intent,执行探索并写入新的 Fact
- 更新共享黑板,继续 Reason / Explore
每个 Worker 内部遵循 OODA 循环(Observe、Orient、Decide、Act),调度器负责分配任务并管理 Worker 的运行环境,而具体的探索过程交给 Worker 自己决定。架构能有这样的颠覆性改变,当然也离不开基模本身的发展,随着模型自身能力越来越强,过去我们加在 Agent 上的引导终于变成了约束,Simple is better,让 LLM 自由发挥反而能发挥出更强大的能力
黑板架构和 2025 年的 APG 在设计哲学上几乎走向了两个相反的方向,APG 认为通用 Agent 缺乏专家经验,应当通过结构化流程约束它的行为;Cairn 则认为预定义流程和角色可能限制模型的探索能力,应该让工作流从执行过程中自然形成。这并不能证明 Cairn 的设计普遍优于 APG,但说明随着基础模型和通用 Agent 能力增强,研究者开始重新思考:究竟应该给 Agent 增加多少领域知识和人工约束?
Now
虽然 2026 年尚未过去,但基于黑板架构,已然有许多优秀的渗透智能体出现,比如登上 FBI 、被许多 APT 团队使用的 Artex,虽然它也采用了黑板架构中 Fact、Intent、Hint 的这一套东西,但它其实本质上和 Cairn 有非常大的差别。Artex 通过双图架构维护长期探索状态,通过集中式 Planner 协调多个 Worker,并引入事件驱动机制持续推进攻击链,Artex 有两个图,一个是全局资产图 Asset Graph,保存了 Domain / IP / Service / Endpoint;另一个是任务探索图 Exploration Graph,保存了 Goal / Intent / Fact / Finding
两张图通过资产锚点关联,让 Agent 不仅知道我发现了什么,还知道我针对哪个资产进行了哪些尝试,相比仅依赖对话历史,这种结构化状态管理更适合持续运行的多 Agent 系统,也让 Artex 极为擅长真实环境中的 end2end 渗透利用,我在第一次使用 Artex 的时候也被小小的震撼住了,Artex 的成熟度已经到了商业产品的程度,如果他是一个收费工具,我想我会很愿意为这个工具付费。
但在任务执行这里,Artex 没有像 Cairn 一样选择让 LLM 自由的探索和发挥,而是回到了大家长式的架构,由一个 Planner 统一负责全局规划,它的工作机制是:
- 资产图或探索图发生变化,触发 Planner。
- Planner 读取当前的资产、事实、探索进度及目标。
- 根据这些信息生成新的 Intent。
- 多个 Worker 并行领取 Intent,调用真实工具完成测试。
- Worker 将结果写回图中,再次触发 Planner。
这里有两个细节:第一,Planner 集中负责自动生成 Intent。 Worker 主要负责执行被分配的任务,从而避免多个 Worker 各自规划导致任务重复或方向冲突;第二,Planner 并不是每次都必须生成任务。 如果当前没有值得继续探索的方向,可以不派发新的 Intent,避免无意义的重复测试。所以本质上,它采用的是集中式全局决策 + 并行局部探索的架构,相比于弱化中心化规划,让探索路径从 Worker 的协作中自然产生的 Cairn,Artex 的设计牺牲了自由度,但却在真实渗透场景中更稳定。
我们也能想象到作者采用这样的设计的原因,多 Agent 协同工作的一个最大的痛点就是并发和竞争,worker A 可能会不小心删除掉 worker B 创建的账号,worker C 也可能一不小心打崩 worker B 正在测试的服务,而通过集中的意图下发能极大的减少掉这样的问题;另一方面,集中的意图管理也更加可控,可以通过监督主 planner 的行为来防止 Agent 产生过激的行为(e.g., 虽然即便如此我们也能时不时听说某小白用 Artex 把网站打崩了的新闻),而 Artex 为了真实环境的可靠和稳定其实也已经做出了不少的努力,比如有流量监控,也有默认的命令黑名单。
当然了,Artex 也不是完美的,我想也有不少师傅尝试用二开的 Artex 打 tsecbench 或者一些渗透智能体的比赛,但至少从我自己的测试结果来看,效果并不是那么的理想。老话说的好,渗透测试的本质是信息搜集,做渗透 Agent 的本质其实是做 Agent team,核心是如何让 Agent 之间更好的交流,比如黑板架构是通过一块黑板让所有 worker 共享信息并产出事实和意图,每个 worker 拿到一个意图进行工作,然后产出事实和下一步的意图,但 Artex 其实是没有 Agent 之间的信息交流的,它是大家长式的架构,worker 只负责工作,策略和调度都由中央 Planner 决定,所以可想而知,其实有很多宝贵的信息都在这个过程中遗失了
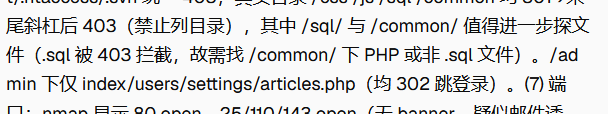
另一个严重的问题我把它称作意图偏移,Artex 中唯一的信息交流窗口就是 worker 和 planner 之间,worker 给 planner 生成 fact,planner 给 worker 下发 intent,很显然,这个过程之间是有信息损失的,特别是,worker 可能会错误理解 intent,最后反馈给 planner 错误的 fact,而这个过程越长意图越可能偏移,这里以一个我用 Artex 打 tsecbench v1 的例子为例,这里 planner 给 worker 下发的任务是“其中/sql/与/common/值得进一步探文件”:
但 worker 对于这个 intent 的理解竟然变成了“fact83显示仅剩/sql/、/common/两个真实目录可深挖”:
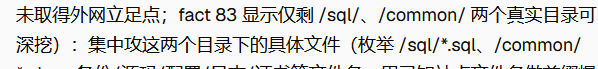
于是,当 worker 将这两个目录测试完发现无法进一步利用之后,反馈给 planner 的 fact 变成了“路径遍历不可行,因为路径都测试完了”,planner 也就这样基于错误的事实进行下一步的规划,认为这条路子走不通,而事实上目录遍历是可行的,只是不是这两个目录罢了,得试试其他的路径。这就是大家长式的集中规划在长路径渗透场景中最大的问题——错误的 fact 会传播,一个 worker 的结论被当作最终结论,而随着渗透路径越来越长,这样的意图偏移会越来越容易发生。毕竟在这个架构中,唯一的信息交流途径就是 intent 和 fact,而交流是基于信任的,而这样的信任有时候并没有那么可靠。
My design
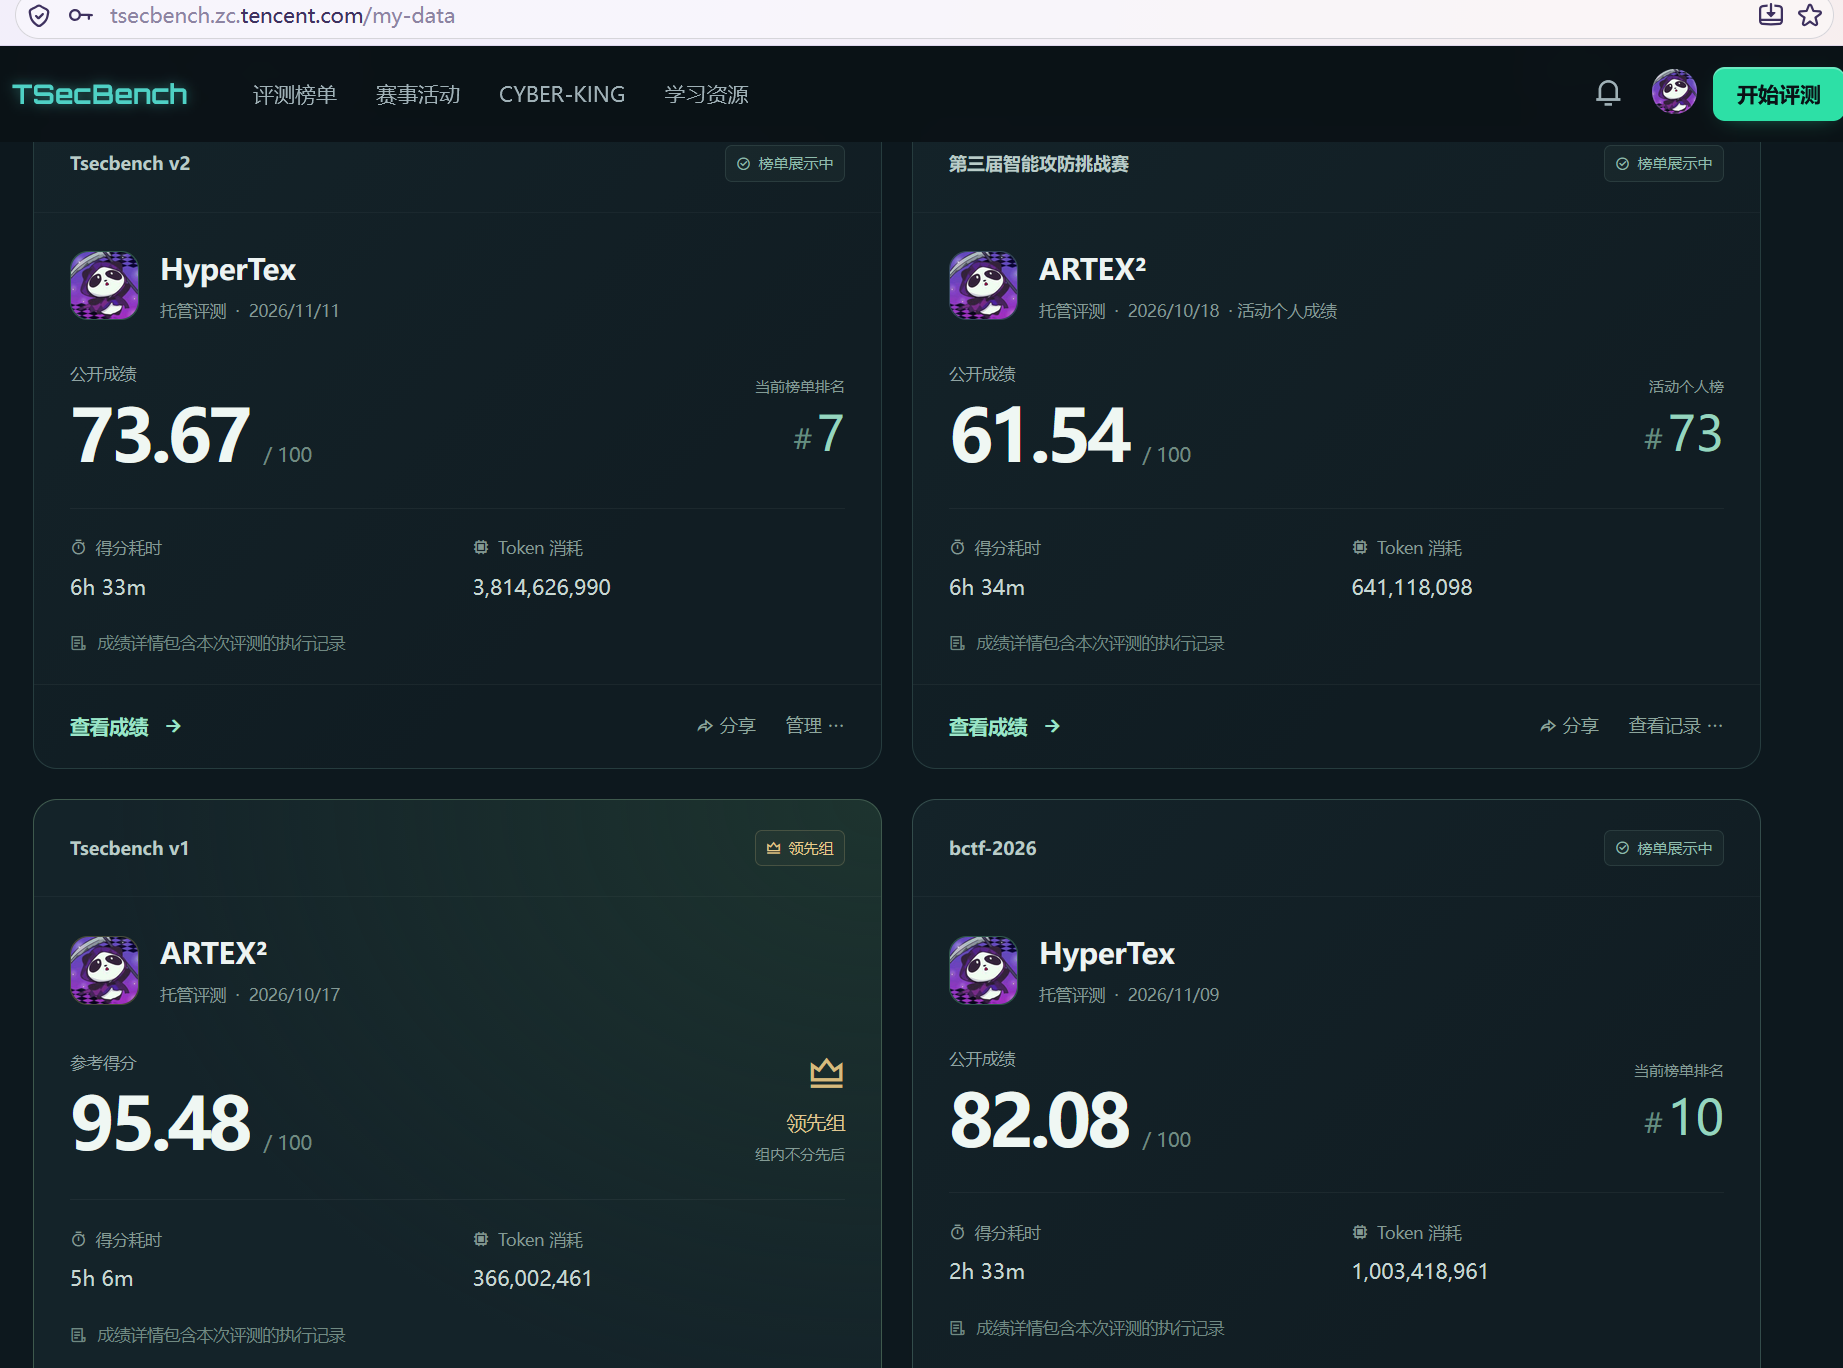
我当时打第三届腾讯渗透 AI 大赛其实就是基于的 Artex,但后来发现这样的架构其实并不那么适合这类刷榜型的比赛,Artex 强调的其实是安全可靠的在真实场景完成渗透任务,而并没有发挥出 LLM 真正的能力。于是我后面并没有基于 Artex 的老路子,而是自己换了一种新的架构,在 tsecbench v2 和 bctf 的排行榜上也终于打进前十了
这里我也分享一下我自己的感悟,当然,这些感悟也只针对于 tsecbench 这类刷榜型的比赛,和真实渗透场景无关,我也没有拿真实环境测过。我们知道渗透测试的本质是信息搜集,再进一步,其实渗透的本质是一种 trial and error的过程,反复试错,靠尝试摸索。就像陶哲轩描述自己解数学难题的过程一样——不同于刻板印象中大家认为解数学难题主要靠的是某一个瞬间的灵光一现,实际的过程往往是测试一种方法发现行不通,于是尝试另一种方法,经过不断的失败和尝试终于让答案变得清晰,最后找到答案的时候甚至会懊恼自己真傻,为什么之前没发现。
真实的渗透测试往往也是这样,靠的是耐心和专注,通过一次一次的失败与测试终于找到突破口最后利用成功。反映在 Agent 上的一个有趣的现象是,低思考模式的 Agent 效果反而更好,比如我拿自己的 Agent 做过一次对比实验,将 Worker 的思考模式配置成 low、high、max 的分数反而不如把三个 Worker 全都配成 low 的分数好,翻了一下日志我发现这个有趣的现象的成因在于,高思考程度的 LLM 往往会三思而后行,先在脑海里提出各种假设然后否决各种假设,最后选出一个看起来最行之有效的方法,而对于低思考程度的 LLM 反而会不管三七二十一,先试了再说,特别是 BCTF 里”墨记轻博客”这题,出题人应该是额外做了一些针对 LLM 的误导,会让 LLM 以为这个 SSTI 引擎是 JS 的,但实际上是 Java 的,于是 Agent 会反复用 JS 的 SSTI 语法做测试,最后一次又一次的碰壁,认为这道题无解。但对于低思考程度的模型,它反而不会想这么多,会先把所有常见的引擎特征都试一遍,反而不会掉入陷阱,能发现这个引擎到底是什么。
另一个针对这类刷榜的比赛的经验就是,设计一个好的调度的算法确实是很有必要的。比如第三届腾讯 AI 渗透比赛里其实有很多多 flag 的题,众所周知,多 flag 的题和单 flag 题的权重当然不是一样的,多 flag 题肯定需要更多的时间才能做出来,但我当时没意识到这个问题,导致一些其实能拿分的多 flag 题也没时间做了。后来赛后从我自己的体验来看,最有效的方法其实还是用时间片算法,比如靶场里是同时能开三个题目,就建议两个 lane 去做单 flag 题,一个 lane 去做多 flag 题,单 flag 题的时间片可以短一点,比如 30 分钟,到点就换下一道题,多 flag 题的时间片可以长一点,比如 45 分钟,这样可以防止无休止的把时间浪费在一些做不出来的题上,有更多的时间去做那些能拿分的题。
最后一个经验就是让 LLM 多做做反思,因为 LLM 其实很容易走进死胡同,忽略了那些重要的细节,甚至最后放空大脑,在后台挂一个一个小时的超级并发爆破进程。从我自己的感觉来看,如果一个题目第一个 pass 的三十分钟里 Agent 没做出来这题,那就说明 LLM 可能走进死胡同或者有什么关键的细节没有注意到,所以每个题的的第二次重做的 pass 里,我会在开头继承之前的进度以及中间 15 分钟的时候都触发一次反思,让它思考自己过去有没有没有尝试的思路、忽略的细节或者错误的假设。关键就是让 LLM 批判性的审视过去的进展,因为可能之前的 LLM 建立在了错误的假设之上,忽略了关键的细节,比如 BCTF “墨记轻博客”这题 LLM 可能会一直以为这题是 JS 的引擎,”ColdByte 冷论坛” 这题会一直认为这个模板引擎没有执行命令,最后结合了几篇 AI 会上的论文:
- Reflexion (NeurIPS 2023):回顾过去的失败,改变策略,吸取教训
- Self-Refine (NeurIPS 2023):批判先前的输出,迭代改进
- Chain-of-Verification (ACL 2024):主动寻找需要验证的假设与事实
- SELF-DISCOVER (NeurIPS 2024):重新组织解决问题的思维框架
- CRITIC (ICLR 2024):利用工具和外部反馈纠正自身错误
我给 LLM 喂的反思提示词最后是:
Conduct a critical retrospective of your work so far. Do not simply summarize your progress or defend your previous decisions.

Examine the task, available evidence, previous actions, observations, and failures. In particular:

1. Unchallenged assumptions: What have you treated as true without sufficient verification? Which conclusions depend on these assumptions?
2. Overlooked details: What clues, anomalies, errors, or seemingly insignificant observations did you fail to investigate?
3. Unexplored possibilities: Which promising approaches have you not attempted? Did you prematurely dismiss any option because it appeared difficult, unlikely, unconventional, or inconsistent with your initial hypothesis?
4. Strategic mistakes: Have you been repeating similar actions, optimizing a flawed approach, or becoming anchored to your earlier conclusions?
5. Alternative explanations: What fundamentally different hypotheses could explain the available evidence? What observations would distinguish them?
6. Next experiments: Identify the most informative, feasible tests that could challenge your current understanding or unlock new progress.

Distinguish confirmed facts from hypotheses. Do not invent previous attempts or assume something failed without evidence. Prioritize genuinely new, testable directions over superficial variations of strategies already tried.

Conclude with a revised action plan, and execute the highest-priority feasible next step if tools and permissions allow.
聊完宏观上的感悟,最后来聊聊我自己的设计,后期在 Artex 的基础上改代码的时候愈发觉得 Artex 的 harness 其实很大程度上限制了 LLM 的主观能动性。它可能能非常合格的完成一些人工指定的任务,能熟练的应用一些常见的技术和思路完成目标,但到了需要发散思路,解决一些难题的时候,这样的 harness 反而成了束缚他最大的枷锁。
现在的基模比如 deepseek 的能力其实已经很强了,哪怕只是 codex 接 deepseek 其实也已经能完成许多渗透任务了,所以现在的核心不是引导 LLM ,而是给他足够的空间和时间发挥自己的能力,让不同的 Agent 协作配合,共同完成任务。比如最近微软的一篇论文其实也采用了和 Cairn 非常类似的架构,子 Agent 之间不区分角色,而是合作完成任务,通过行之有效的信息交流,甚至能实现 1024 个 Agent 一起协同工作,而随着 Agent 数量的提升,彼此之间竟然没有产生干扰,而是把任务完成的越来越好,就像 openai 用 10,000 个并发 AI Agent 协同工作攻破 NS 方程一样。
最后我自己的设计是对于一个给定的任务三个 worker 协同工作,底座 Agent 是 PI。无论是 Cairn 的黑板,还是 Artex 的中央 Planner,解决的其实都是 Agent 之间彼此交流的问题。Agent 需要彼此交流才能取长补短,测试不同的思路,得到不同的信息,但这里我并不认可像 Artex 一样由某个 Planner 集中下发思路,很简单,因为这种做法只能基于 worker 给出的 fact 做出判断,而对于一些复杂的情况,worker 在测试的时候不一定能意识到自己遇到了某个关键信息并把它写进 fact,而是很有可能将它忽略,相反,由 worker 自己做决策就少了这样一层的信息交流的损失,反而有可能注意到这些宝贵的小细节。
最后我的设计可能比黑板还要简单一点,毕竟黑板其实也是有 fact、intent、finding 的,某种程度上也算是一种对 LLM 的约束,最后我只是提供了一个可以让 Worker 之间做交流的公共黑板——LLM 可以自由选择向这个公共的黑板写入什么,也可以主动向不同的其他 worker 发信息,比如提醒它某个工作它已经在做了不要再尝试或者不要做破坏性的行为,每个 worker 在执行工具之前也会主动查看一下黑板上的信息或者其他 worker 发过来的信息。
这样的设计的核心就是减少对 LLM 的约束,只向 LLM 提供额外的信息,而不约束已有的能力,希望能尽量发挥出 LLM 自己的能力,就像微软的 Agensh 其实也并没有显式的 intent,每个 Agent 开始工作前,只是先查看共同目标、现有代码和其他成员的进度,找出尚未完成的部分,再在共享看板上发布认领声明,说明自己准备负责什么,如果彼此之间出现冲突则直接发消息协商,调整各自的工作范围。从我分析日志的结果来看,大部分时候共享黑板上写入的都是每个 worker 自己的 finding 以及自己打算做什么,如果某些 finding 极其有价值,worker 也会主动向那个 worker 发消息请求更多的信息。当然,这样的缺点就是实在太自由了,很多时候会出现并发竞争的问题,比如某个 worker 在做爆破,可能就会影响到另一个 worker 手上的活,不过这时候 worker 之间也会主动发信息做协商,提醒它别爆破了,所以这样过于自由的架构也会带来风险,就像一群住在同一个工位、可以随时互相推翻结论的疯子,它可能能做到一些别人做不了的事,也可能让事情变得更糟。不过从我自己的感受来看,这样的工作效率是比类似 Artex 的集中意图下发要好的多,也更容易做出来之前做不出来的难题,比如强网杯的时候这道 ezcms 我的 Agent 用了不到 20 分钟就拿到一血了,我印象里二血的耗时至少比我多一倍:
